Tracktailor — une expérience d’apprentissage automatique
Une exploration du montage musical automatisé
J’écoute entre trois et sept heures de musique par jour. Sans exagérer.
Chaque fois que j’écoute un morceau, je me demande s’il pourrait servir dans un showreel ou une pub. Si oui, je commence à le monter dans ma tête : repérer le climax, trouver un bon début et une bonne fin, puis chercher où couper pour le faire tenir en une minute sans en casser le rythme. Ne me demandez pas pourquoi. C’est simplement comme ça que mon cerveau fonctionne.
Cette habitude m’a donné une idée : est-ce qu’un programme pourrait trouver ces cuts à ma place ?
Tracktailor est construit là-dessus : une intro, un climax et une fin. Il faut repérer ces moments, puis trouver comment les relier pour que le morceau tienne en une minute tout en gardant sa progression.
Je me demande surtout comment traduire en code ce que je fais à l’oreille. Qu’est-ce qui fait qu’un cut passe bien, alors qu’un autre sonne faux ? Est-ce que je peux commencer par quelques règles, puis entraîner un modèle à partir des transitions que je trouve réussies ou ratées ? C’est une bonne occasion de mettre les mains dans le machine learning avec quelque chose que j’ai envie d’écouter.
L’approche naïve, c’est de repérer un passage qui fonctionne sur une minute et de le garder tel quel, sans avoir à couper dedans. Parfois, ça suffit. Mais l’intro que je veux est au début, le climax arrive deux minutes plus tard et la fin est encore ailleurs. Pour les réunir, il faut enlever les passages qui les séparent et trouver des raccords qui passent à l’oreille. Je commence donc par chercher ce que je peux mesurer dans le son pour reconnaître des passages susceptibles de bien s’enchaîner.
Je commence en Python avec librosa, une bibliothèque d’analyse audio. Elle me permet d’estimer le tempo, de repérer les temps et de mesurer comment le son évolue au fil du morceau. Je peux aussi utiliser Beat This pour repérer les temps et les débuts de mesure. Les temps me donnent une grille sur laquelle chercher les cuts : si je quitte le morceau sur le deuxième temps d’une mesure, je cherche une reprise à une position équivalente pour ne pas décaler le rythme.
Il faut ensuite décrire ce qu’on entend autour de ces repères. L’énergie donne une indication du niveau du signal : un écart important entre deux passages peut créer une chute ou un bond de volume au raccord. Le chroma répartit le contenu harmonique entre les douze classes de notes, en regroupant les octaves. Il permet de comparer des couleurs harmoniques sans avoir à reconnaître précisément chaque accord. Les MFCC et le contraste spectral décrivent d’autres aspects de la texture sonore. Deux passages peuvent avoir un volume semblable et sonner très différemment ; ces mesures me permettent de les distinguer.
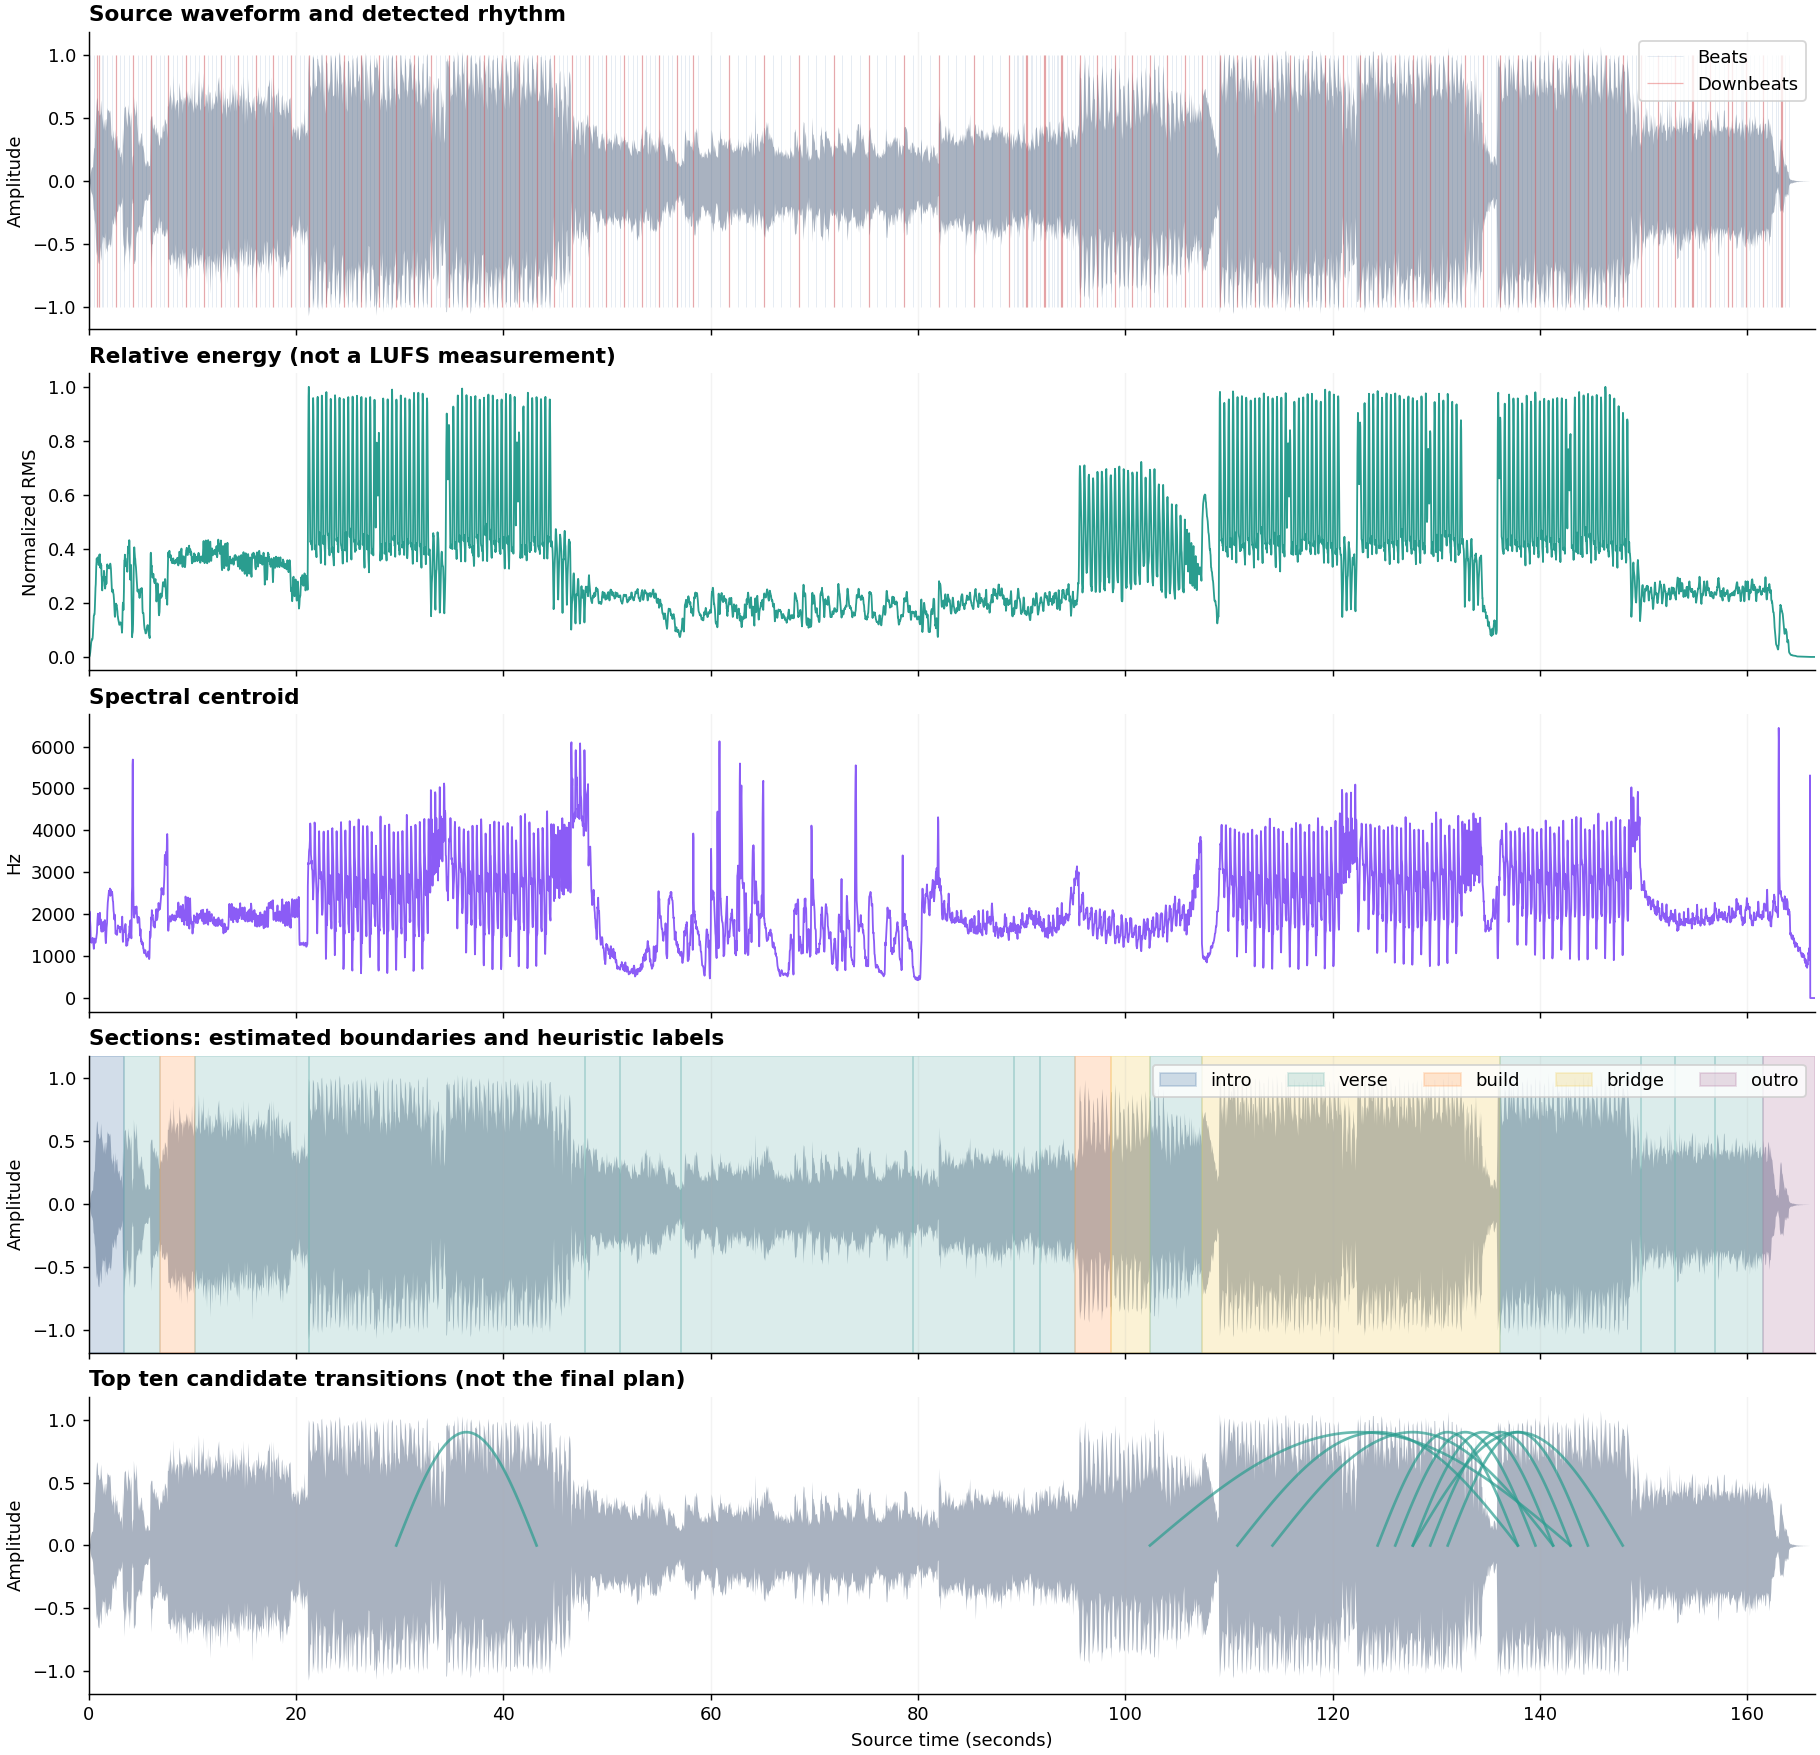
Avec Matplotlib, je rassemble ces informations dans un graphique pour voir les variations d’énergie, les changements de texture et les sections estimées du morceau. Ça me permet de mettre ce que je mesure en face de ce que j’entends.
J’explore aussi Demucs, un modèle déjà entraîné qui sépare notamment la voix de l’accompagnement. En mesurant l’énergie de la piste vocale isolée, je peux estimer où quelqu’un chante et signaler les cuts qui risquent de tomber au milieu. Ça ne me dit pas où se termine un mot ou une phrase : le système détecte une activité vocale, il ne comprend pas les paroles.
À partir de ces repères, je génère des transitions candidates.
Pour éviter de tester toutes les paires possibles, je commence par chercher les cuts sur les temps du morceau. Je teste une reprise quatre mesures plus loin, puis huit, douze, et ainsi de suite. Sur un morceau à quatre temps par mesure, ça revient à retirer 16, 32 ou 48 temps : si je pars sur un deuxième temps, je retombe sur un deuxième temps. J’écarte aussi les sauts trop courts, trop longs ou trop proches du début et de la fin du morceau.
Je compare ensuite le son autour des deux positions. Je prends quatre temps à chaque endroit : deux avant le point de coupe et deux à partir de celui-ci. Je conserve leur ordre pour comparer une petite séquence musicale, plutôt qu’une seule valeur moyenne. Je calcule la ressemblance entre ces séquences à partir du chroma, des MFCC et du contraste spectral, en donnant davantage de poids au chroma. J’écarte les candidats trop différents.
J’attribue ensuite un score aux candidats restants. La ressemblance entre les séquences en est la base : je fais baisser la note quand l’écart d’énergie est important et j’ajoute un bonus quand les deux points tombent sur un premier temps de mesure. Je favorise aussi légèrement les départs proches d’un début de section. Si une voix est détectée autour du départ ou de la reprise, je pénalise le raccord, ou je l’exclus lorsque l’option de protection des voix est activée.
Je ne sais pas trop où je vais, je me dis juste naïvement que par observation et avec du temps, je finirai par avoir quelque chose. J’écoute le résultat, je repère ce qui accroche et j’essaie de comprendre pourquoi. Un cut casse le rythme, un autre coupe une voix, un autre fait tomber l’énergie d’un coup. J’ajuste les critères pour résoudre ces problèmes à mesure qu’ils apparaissent, puis je réécoute pour voir si ça aide vraiment.
Les dix meilleures transitions candidates, visibles sous forme d’arcs en bas du graphique, sont les dix premiers résultats de ce classement.
Il reste à choisir les cuts qui fonctionnent ensemble et permettent d’atteindre la durée voulue. Je m’appuie notamment sur Music Rearrangement Using Hierarchical Segmentation, qui relie la comparaison de séquences de temps à la structure du morceau et à la recherche d’un montage complet. J’en reprends certains principes avec une mise en œuvre plus simple. Scalable Music m’aide aussi à aborder le montage dans son ensemble, en cherchant quels raccords choisir pour atteindre une durée donnée tout en conservant les passages importants.
Par défaut, je centre la recherche sur la durée à retirer. Pour passer de trois minutes à une minute, je cherche une combinaison de sauts qui enlève deux minutes, sans chevauchement et en laissant suffisamment de musique entre les cuts. Je favorise les raccords bien notés tout en évitant de les multiplier, avec une tolérance d’une seconde sur la durée demandée. Je peux aussi protéger la section la plus énergique pour qu’elle ne disparaisse pas dans un cut.
Je construis plusieurs montages en parallèle : à chaque étape, j’essaie d’ajouter des cuts, je compare les possibilités et je ne garde qu’un petit nombre de pistes prometteuses pour la suite. Je tiens compte de la qualité estimée des raccords, de la durée obtenue et des passages à préserver. Un cut très bien noté peut ainsi être laissé de côté si une autre combinaison donne un montage plus cohérent.
Une fois les passages choisis, je les assemble avec des fondus enchaînés : sur un court instant, un son diminue pendant que l’autre prend sa place. Ça aide à adoucir la jonction, mais ça ne répare pas une phrase coupée au mauvais endroit. Sur douze montages issus de quatre morceaux, j’obtiens des durées à moins d’une seconde de la cible. Reste à écouter si le résultat tient la route musicalement.
Voici un exemple conservé des premiers essais : une version de « Hold me » passée d’environ 2 min 46 s à 1 min 19 s.
À l’écoute, je vois bien que ces scores ne suffisent pas. Deux accords identiques peuvent appartenir à des phrases complètement différentes. Une transition peut préserver le rythme tout en interrompant une mélodie ou un mot. Et plusieurs cuts acceptables séparément peuvent donner un morceau qui ne va nulle part. Pour aller plus loin, il me faut des exemples de ce qui fonctionne réellement à l’oreille, pas seulement de ce qui obtient un bon score avec mes critères.
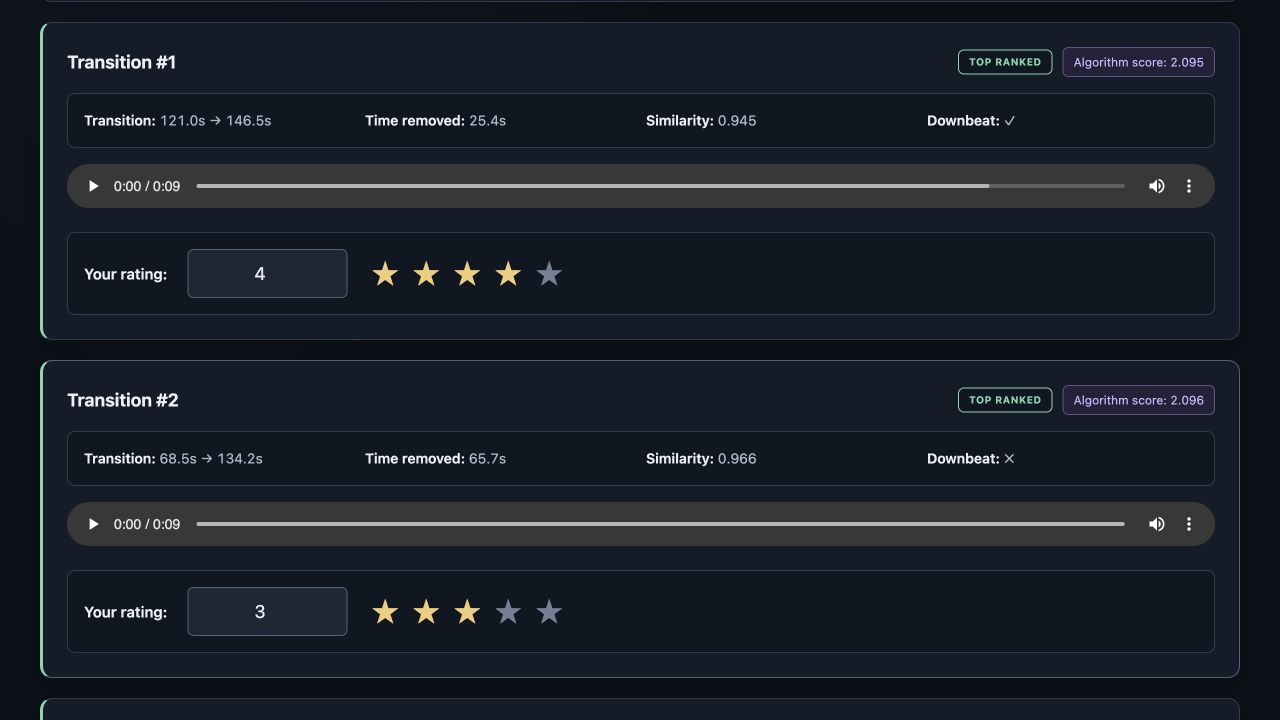
Pour étudier la qualité des raccords, je crée une interface d’annotation avec Flask. Elle joue de courts extraits autour d’une coupe proposée et me permet de leur attribuer une note de un à cinq. Un correspond à une rupture gênante ; cinq, à une transition que je remarque à peine. Je mélange les propositions les mieux classées par l’algorithme, les moins bien classées et des exemples choisis au hasard.
J’ai annoté 450 cuts sur neuf morceaux. Honnêtement, écouter et noter toutes ces transitions a failli me rendre fou. Annoter de la musique est épuisant : réécouter les mêmes passages en boucle, juger des différences infimes et essayer de rester cohérent sur des centaines d’exemples est vraiment difficile.
J’essaie ensuite de prédire mes notes à partir des caractéristiques audio, avec LightGBM et des modèles plus simples, en utilisant pandas et scikit-learn pour préparer les données et évaluer les résultats. Pour tester la capacité de généralisation, je laisse un morceau de côté : entraînement sur huit morceaux, évaluation sur le neuvième, puis répétition de l’opération pour chacun des morceaux.
Avec LightGBM, j’utilise des arbres peu profonds et de la régularisation pour limiter le surapprentissage, c’est-à-dire éviter que le modèle colle aux exemples d’entraînement sans réussir sur d’autres morceaux. Je prends aussi en compte les variations de volume, d’attaque et de contenu harmonique. Malgré ça, les prédictions restent souvent proches d’une note moyenne et passent à côté de nombreuses transitions que je cherche à repérer.
Pour voir si le modèle apporte quelque chose, je le compare à une méthode très simple : toujours prédire la note médiane des exemples d’entraînement. Voici l’erreur moyenne sur les morceaux laissés de côté :
| Méthode | Erreur absolue moyenne |
|---|---|
| Prédiction de la note médiane du jeu d’entraînement | 0,840 |
| Régression ridge | 0,929 |
| LightGBM régularisé | 0,853 |
L’erreur est mesurée en points sur l’échelle de 1 à 5 ; plus elle est faible, mieux c’est.
LightGBM ne fait pas mieux que la médiane sur ce test. Je n’ai donc pas de gain mesurable sur la prédiction des notes avec cette expérience. Les cuts que je fais écouter ici sont choisis avec les critères décrits plus haut ; ils ne démontrent pas que le modèle a appris à mieux monter la musique.
Avec le recul, je vois plusieurs limites dans ma façon de m’y prendre. J’ai 450 annotations, mais elles viennent de seulement neuf morceaux : beaucoup d’exemples se ressemblent, et ça laisse peu de diversité pour apprendre à juger une musique inconnue. J’ai aussi assez peu de très bons raccords à montrer au modèle. Lui donner davantage d’exemples variés, avec plus de transitions réussies, serait une première piste à tester.
Mes notes sont une autre limite. Je suis le seul à noter les cuts. À force de réécouter les mêmes passages, il devient difficile de garder le même niveau d’exigence d’une écoute à l’autre. Je demande au modèle de reproduire un jugement que j’ai moi-même du mal à rendre parfaitement cohérent. Faire écouter les mêmes cuts à plusieurs personnes aiderait à voir sur lesquels on s’accorde vraiment.
Enfin, je résume chaque raccord par des mesures de rythme, d’énergie et de texture, alors qu’à l’écoute je juge aussi la mélodie, la fin d’une phrase et ce que j’attends de la suite. Rien ne garantit que les informations que je fournis suffisent à expliquer mes notes. Et prédire une note avec peu d’erreur ne répond pas exactement à ma question de départ : parmi les cuts possibles, lesquels garder ? Ce sont des pistes pour comprendre le résultat, pas des causes que j’ai isolées et vérifiées une par une.
J’ai consacré trois jours à cette expérimentation, et pour moi c’est assez. Je voulais essayer une idée et comprendre comment passer de mon intuition à un montage automatique. Je repars avec quelques cuts qui me plaisent, mais aussi une idée beaucoup plus concrète du travail nécessaire pour constituer des données utiles et vérifier qu’un modèle apporte quelque chose. Pour aller plus loin, il faudrait surtout reprendre les annotations et la façon d’évaluer les résultats. Je m’arrête là pour le moment.
Voici un court extrait avec un cut à la cinquième seconde.
Quand le raccord fonctionne, c’est satisfaisant.
En attendant, je suis curieux : que pensez-vous de cette transition ?
Loading a cut…